KNOWLEDGE HUB
ナレッジハブ
2026/10/16
AIのクローラーを止めていないか。robots.txtで確かめる設定と判断基準

AIのクローラーの役割と名前の見分け方
robots.txtで止めている箇所の見つけ方
止めるページと許可するページの決め方
AIクローラーをrobots.txtで止めていないか、自社サイトの設定が気になっている方もいるのではないでしょうか。AIの答えに自社が出てこない理由を探すと、サイトの入り口で巡回を断っていたという例が見つかります。
結論から言えば、ファイルとサーバーの設定を順に見れば止めているかどうかは自分で確かめられます。止めるかどうかの判断も、学習に使うクローラーと答えのために読みにくるクローラーを分けて考えると迷いにくくなります。この記事では、公式の仕様にもとづく書き方と、WordPressやセキュリティの設定で起きやすい見落としを作業の順に整理しました。
読み終えるころには、どのページを許可しどのページを止めるかまで判断できるようになります。
1. AIのクローラーの役割
AIのクローラーは、AIが使うWebページを集めて回るプログラムです。人が質問するたびに初めてページを探すのではなく、決まった名前を名乗る巡回プログラムが先にページを読みにきます。この巡回を断ると、AIは自社サイトの文章を材料にしにくくなります。そのため、AIの答えに自社が出るかどうかはサイトの入り口の設定にも左右されます。
クローラーは、ページを読む前にサイトの直下にあるrobots.txtを確かめるのが一般的な動きです。このファイルは1994年に生まれた取り決めで、2022年にはRFC 9309として仕様が文書になりました。AIの運営元も、それぞれのクローラーがこのファイルに従うと公式の説明で示しています。2026年現在、クローラーの名前は役割ごとに分かれているため、名前を見れば何のために読みにきたかがわかります。
現場でよく見られるのは、AIのクローラーをひとまとめに考えて、すべて止めるかすべて許可するかで迷うケースです。実際には、学習のために集めるものと答えを作るときに読みにくるものでは、止めたときの影響が違います。まずは自社サイトのURLの末尾に「/robots.txt」を付けて開き、書かれている内容を書き写してください。
学習のための巡回と答えのための巡回
AIのクローラーは、大きく学習のための巡回と答えのための巡回に分かれます。学習のための巡回は、集めた文章をAIのモデルの材料にするものです。答えのための巡回は、利用者の質問に合わせて今のページの内容を読みにいくものです。
前者を止めても、後者を許可していれば答えの材料として読まれる余地は残ります。自社の方針を決める前に、この2つを分けて書き出しておきましょう。
クローラーは名前を名乗って訪れる
クローラーは、ページを取得するときにユーザーエージェントという名前を名乗ります。robots.txtはこの名前を手がかりに、どのクローラーにどのルールを当てるかを決めます。たとえばOpenAIの学習用は「GPTBot」、検索用は「OAI-SearchBot」と名乗ります。
名前は運営元の公式ページに一覧で載っているので、書く前に最新の表記を確かめてください。綴りを1字でも間違えると、そのルールは当たらなくなります。
関連記事:llms.txtは意味ないのか?置く前に確かめたい役割と限界
2. 検索のクローラーとの違い
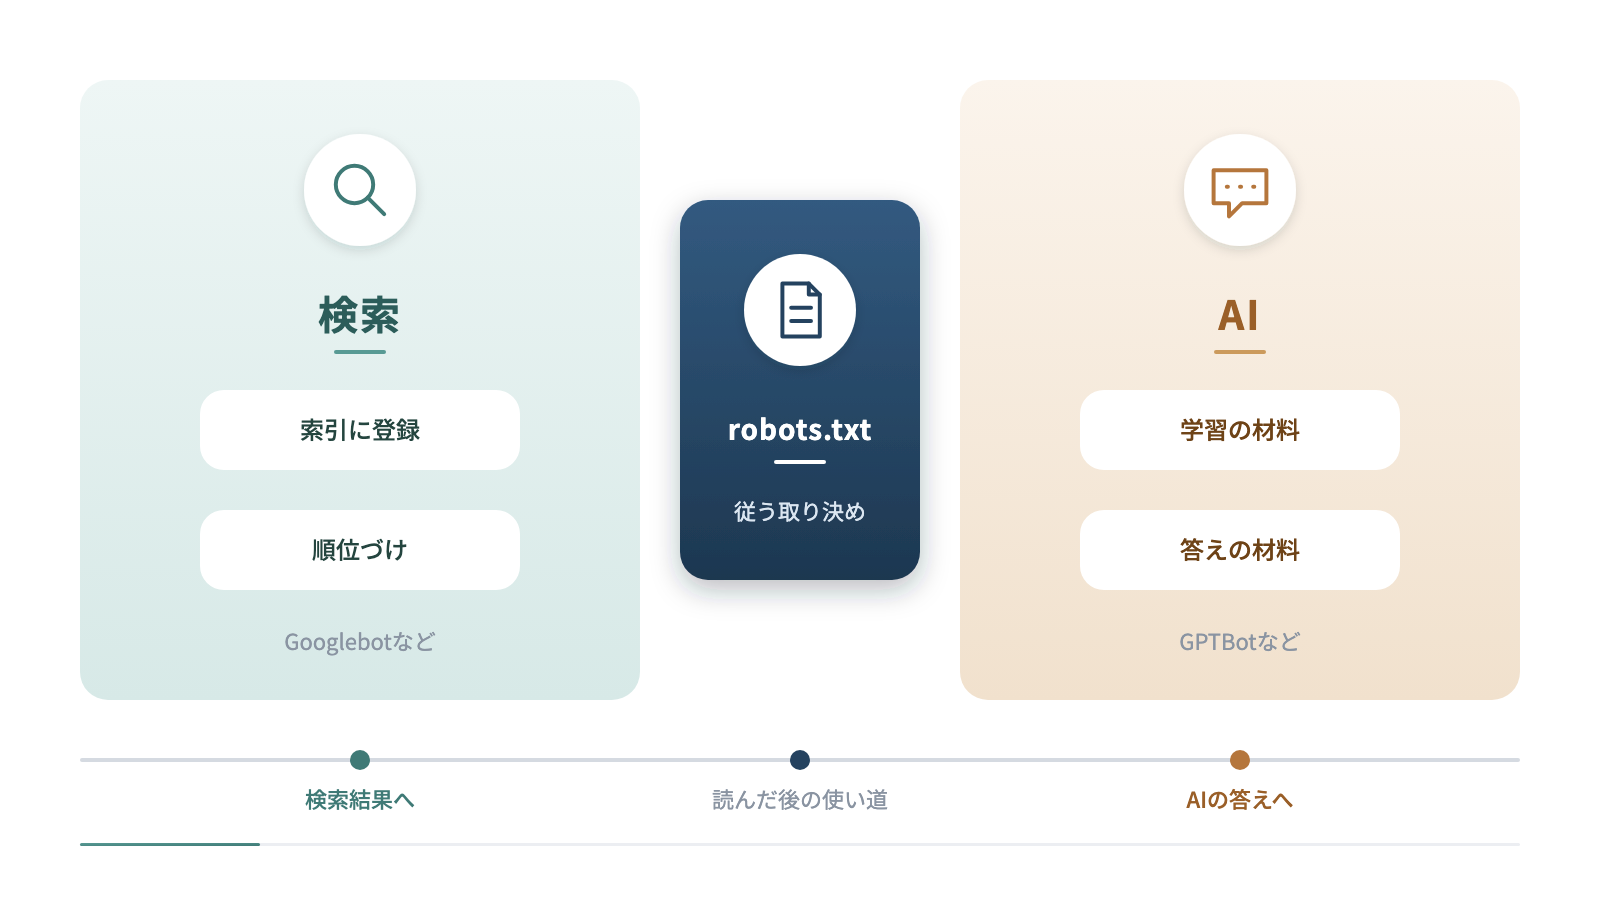
検索のクローラーとAIのクローラーの違いは、読んだページを何に使うかにあります。検索のクローラーは、ページを索引に登録して検索結果の順位づけに使います。AIのクローラーは、モデルの学習や答えの文章づくりの材料として使います。仕組みはどちらもrobots.txtに従って巡回する点で共通しています。
注意したいのは、Googleの場合は検索とAIの境目が1つのクローラーにまとまっている点です。GoogleのAI OverviewsやAIモードは、通常の検索と同じGooglebotが集めたページを使います。一方で「Google-Extended」という名前は、Geminiなどのモデルに使うかどうかを決めるための目印です。Googleの説明では、Google-Extendedを止めても検索の表示は変わらないとされています。
よくある失敗は、AIに使われたくないからとGooglebotそのものを止めてしまうことです。そうすると、AI Overviewsだけでなく通常の検索結果からも外れていくおそれがあります。止めたい範囲が学習だけなのか答えへの表示も含むのかを、表で整理してから設定に進んでください。
| 項目 | 検索のクローラー | AIのクローラー |
|---|---|---|
| 主な使い道 | 索引への登録と順位づけ | 学習や答えの材料 |
| 代表的な名前 | Googlebot | GPTBot・ClaudeBotなど |
| 止めたときの影響 | 検索結果に出にくくなる | AIの答えに使われにくくなる |
| 従う取り決め | robots.txt | robots.txt |
AIの答えの多くは検索の仕組みを通る
AIの答えの多くは、検索の仕組みで見つけたページをもとに作られます。ChatGPTやPerplexityは、質問に合わせてWebを検索し、見つかったページを読んで答えをまとめます。このとき読みにくるのは、各社の検索用のクローラーです。
検索用を止めると、学習とは関係なく答えの材料から外れることになります。答えに出たいなら、検索用のクローラーは許可しておくのが基本です。
Googleは検索とAIを同じ入り口で扱う
Googleでは、検索とAIの入り口が同じGooglebotです。AI Overviewsに出るかどうかは、通常の検索に出られる状態かどうかが前提になります。そのため、Googlebotを止めると検索とAIの両方に効くと考えておきましょう。
一方でGoogle-Extendedだけを止めれば、検索の表示を保ったままモデルへの利用を断れます。Googleに対しては、この2つの名前を分けて扱ってください。
3. robots.txtで許可・拒否する仕組み
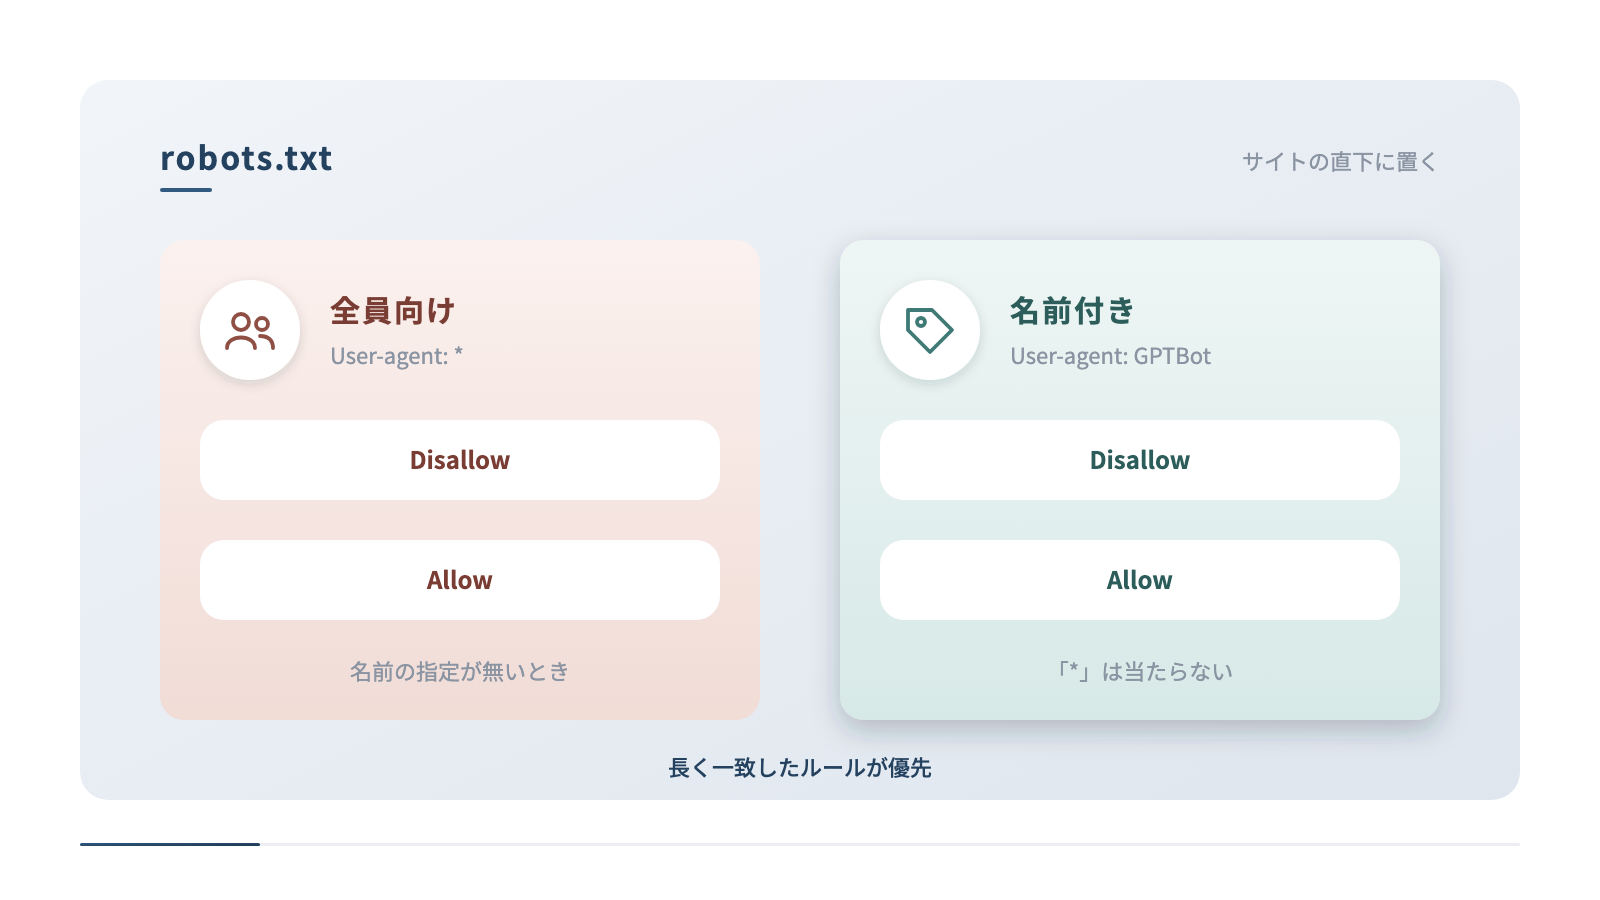
robots.txtは、クローラーの名前ごとに読む範囲を伝えるファイルです。ファイルはサイトの直下に置き、「https://example.com/robots.txt」のURLで開ける状態にします。クローラーはこのファイルを先に読み、自分に当てはまるルールに従って巡回します。ルールはUser-agentの行で相手を決め、その下にAllowとDisallowを並べて書きます。
書き方の基本は3種類の行です。「User-agent: GPTBot」で相手を決め、「Disallow: /private/」で止める場所を書きます。止めた場所の中で読ませたいページがあれば、「Allow:」で例外を足します。RFC 9309では、いちばん長く一致したルールが優先されると定めています。
現場でよくある誤解は、robots.txtを鍵のかかった扉のように考えることです。このファイルはあくまでお願いの取り決めで、従わないプログラムを止める力はありません。人に見せたくないページは、パスワードやログインで守る設定を別に用意してください。
robots.txtを書くときの3つの決まり
ホストごとに別のファイルが要る
このファイルは、ホストごとに別々に読まれます。「www.」の有無やサブドメインが違えば、それぞれに別のファイルが必要です。たとえばブログを別のサブドメインで運営しているなら、そのサブドメインの直下にも置く必要があります。
httpとhttpsでも別のものとして扱われる点に気をつけましょう。運営しているドメインとサブドメインを書き出し、1つずつ開いて確かめてください。
グループの選ばれ方を知っておく
クローラーは、自分の名前にいちばん具体的に一致するグループだけを読みます。「User-agent: *」はすべてのクローラー向けのグループで、名前を指定したグループが無いときに使われます。逆に言えば、GPTBot専用のグループを作るとGPTBotには「*」のルールが当たらなくなります。
全員向けに止めていた管理画面も、名前付きのグループに書き写す必要があります。グループを足したときは、全員向けのルールを写しているかを確かめてください。
4. 主なAIクローラーの名前と運営元
主なAIクローラーは、運営元ごとに役割の違う複数の名前を使い分けています。OpenAI・Anthropic・Perplexity・Googleは、公式のページで名前と役割を公開しています。名前を知らないまま設定すると、止めたい相手を外したり許可したい相手を止めたりします。robots.txtを書く前に、名前と役割の対応を一覧で手元に置いておきましょう。
名前はおおむね学習用・検索用・利用者の操作用の3つに分かれます。たとえばOpenAIは学習用に「GPTBot」、検索用に「OAI-SearchBot」、操作用に「ChatGPT-User」を使います。Anthropicは「ClaudeBot」「Claude-SearchBot」「Claude-User」を同じ考え方で分けています。Perplexityは、検索用の「PerplexityBot」と操作用の「Perplexity-User」を公開しています。
よくある失敗は、古い記事に載っていた名前をそのまま写すことです。名前は追加や変更があるため、数年前の一覧では新しい検索用のクローラーが抜けていることがあります。設定する日に運営元の公式ページを開いて、名前の綴りと役割を確かめてから書いてください。
| 運営元 | 学習用 | 検索用 | 利用者の操作用 |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | ― | PerplexityBot | Perplexity-User |
| Google-Extended(目印) | Googlebot | ― |
検索用のクローラーは答えへの近道
AIの答えに自社を出したいなら、検索用のクローラーを許可しておくことが近道です。検索用は、質問に合わせて見つけたページを答えの材料として読みにきます。OpenAIの説明では、OAI-SearchBotを止めたサイトは検索の答えに表示されにくくなるとされています。
学習用を止めるかどうかとは、別に判断できる点を押さえておきましょう。止める・許可するの判断は、名前ごとに1行ずつ表に書いて残してください。
利用者の操作で読みにくるもの
利用者の操作用のクローラーは、人がAIに「このページを読んで」と頼んだときに動きます。たとえばChatGPTにURLを貼って要約を頼むと、ChatGPT-Userがそのページを取得します。巡回して集めるのではなく、1回の依頼ごとに読みにくる点がほかの2つと違います。
運営元によっては、この種類にはrobots.txtのルールが当たらない場合があると説明しています。止めたい事情があるときは、運営元の説明を読んでから設定を決めましょう。
あわせて読みたい:WordPressで始めるホームページ制作|テーマ・プラグイン・SEO設定の基本
5. 知らないうちに止めている典型例
AIのクローラーを止めてしまう原因は、意図した設定より昔の設定の残りであるケースが目立ちます。サイトの公開前に入れた全面拒否や、制作会社が入れたルールがそのまま残っていることがあります。担当者が替わると、なぜその行があるのかを誰も説明できなくなります。そのため、今のファイルを1行ずつ読み、理由のわからない行を洗い出すことから始めます。
典型例は大きく3つです。1つ目は「User-agent: *」の下に「Disallow: /」が残り、サイト全体を止めているものです。2つ目は、AIの名前を並べて一括で拒否するルールを、どこかの記事から写したものです。3つ目は名前付きのグループを足したことで、全員向けのルールが外れたものです。
もう1つ見落としやすいのが、ファイルそのものがエラーを返している場合です。Googleの説明では、このファイルがサーバーの不具合で5xxのエラーを返すと、サイト全体の巡回を控える扱いになります。ブラウザでファイルを開き、内容とあわせて正しく表示されるかを確かめてください。
公開前の設定がそのまま残る
サイトを作っている間は、検索に出ないよう全体を止めることがよくあります。公開のときにこの設定を外し忘れると、検索とAIの両方から読まれない状態が続きます。特にテスト環境の設定を本番へ写したときに起きやすく、公開から数か月気づかない例もあります。
公開日のチェック表に、このファイルを開いて確かめる項目を足しておきましょう。すでに公開しているサイトも、今日のうちに1回開いて確かめてください。
よそのルールを写して止めすぎる
AIの名前を並べた拒否の一覧は、Web上で見つけやすく写しやすいものです。ただし、その一覧には検索用のクローラーまで含まれていることがあります。写したまま使うと、学習だけを断るつもりがAIの答えへの表示まで断ることになります。
一覧を使うときは、1行ずつ名前を調べて役割を書き添えてください。役割がわからない名前は、調べ終わるまで足さないのが安全です。
6. WordPressやセキュリティプラグインの影響
WordPressのサイトでは、robots.txt以外の設定がクローラーを止めていることがあります。WordPressは、サイトの直下にファイルが無いときに仮想のrobots.txtを自動で返します。さらに、SEOのプラグインやセキュリティのプラグインが、この中身や巡回の扱いを変えます。そのため、ファイルだけを見ても本当の状態がわからない場合があります。
最初に見るのは、管理画面の「設定」→「表示設定」にある検索エンジンでの表示の項目です。「検索エンジンがサイトをインデックスしないようにする」にチェックが入っていると、検索エンジンに読まないよう伝える状態になります。次に、SEOのプラグインにrobots.txtの編集画面があるかを確かめます。サイトの直下に実際のファイルを置いた場合は、仮想のものより実際のファイルが優先されます。
よくある失敗は、セキュリティのプラグインが知らない名前のアクセスをまとめて断っているケースです。この場合はファイルに許可と書いてあっても、クローラーにはエラーの画面が返ります。プラグインの設定画面で、ボットやユーザーエージェントを遮断する項目を1つずつ開いてください。
仮想のrobots.txtと実際のファイル
WordPressの仮想のrobots.txtは、標準では管理画面の「/wp-admin/」を止める内容です。ただし、プラグインがこの中身に行を足していることがあります。一方でサイトの直下に実際のファイルを置くと、仮想の中身は使われなくなります。
どちらが効いているかは、ブラウザで開いた表示を正としてください。表示とプラグインの画面が違うときは、直下にファイルが無いかをサーバーで確かめましょう。
ボットの遮断でエラーを返している
セキュリティのプラグインやサーバーの防御の仕組みは、怪しいアクセスを自動で断ります。AIのクローラーは短い時間に何ページも読むため、攻撃と見分けられずに断られることがあります。断られたクローラーには、403などのエラーが返ります。
アクセスの記録で、AIの名前の行にどの番号が返っているかを見てください。200以外が並んでいれば、遮断の設定を見直す合図です。
注意
セキュリティの設定をゆるめるときも、管理画面やログインページの守りは外さないでください。許可するのは公開しているページへの読み取りだけに絞るのが安全です。名前は誰でも名乗れるため、名前だけで通す設定はなりすましを招きます。
7. 止めるべきページと許可すべきページ
止めるべきなのは答えの材料にならないページで、許可すべきなのは会社の説明になる公開ページです。管理画面・ログイン・サイト内の検索結果・カートなどは、AIが会社を説明するときに役立ちません。逆にサービス・料金の考え方・会社概要・よくある質問は、AIが会社を説明するときの材料になります。そのため、ページの種類ごとに止めるか許可するかを先に決めておくと迷いが減ります。
判断の目安は3つの問いです。1つ目は、そのページが公開してよい内容かどうかです。2つ目は、そのページが会社やサービスの説明に役立つかどうかです。3つ目は同じ内容のURLが重複していないかどうかで、並び替えや絞り込みのURLが代表例です。
よくある失敗は、画像やCSSのフォルダまで止めてしまうことです。Googleは、ページの見た目を正しく読むためにCSSやJavaScriptも読み込みます。止めるフォルダを決めたら、その中に公開ページの部品が入っていないかを確かめてください。
学習用だけを断るという選び方
答えへの表示は保ちたいが、学習への利用は断りたいという考え方もあります。その場合は、学習用の名前だけを「Disallow: /」で止め、検索用の名前は許可します。たとえばGPTBotは止めてOAI-SearchBotは許可するという組み合わせです。
Googleに対しては、Google-Extendedを止めてGooglebotは許可します。どの名前をどう扱ったかは、決めた理由と一緒に社内の記録に残しましょう。
見せたくないページはrobots.txtで隠さない
このファイルは誰でも開いて読める公開のファイルです。止めたいURLを書き並べると、かえってその場所を人に教えることになります。見せたくないページは、パスワードやログインで守るのが正しい方法です。
また、Googleは止めたURLでも、ほかのページからリンクされていればURLだけを検索結果に出すことがあります。検索に出したくないページはnoindexの指定を使い、巡回は止めないでおきましょう。
こちらも読まれています:WordPressで始めるホームページ制作入門|初心者でも安心の基本ガイド
8. 設定後の確認方法
設定を変えたあとは、ファイル・記録・答えの3段で確かめるのが確実です。ファイルを書き換えただけでは、クローラーが新しい内容を読んだかどうかはわかりません。Googleの説明では、robots.txtの中身は最大で24時間ほど保存されてから読み直されます。そのため、変更から1日以上あけてから結果を見るようにします。
1段目は、ブラウザでファイルを開き、書いた内容がそのまま表示されるかを見ます。2段目は、サーバーのアクセスの記録で、AIのクローラーの名前と返した番号を確かめます。Googleについては、Search Consoleのrobots.txtのレポートで読み込んだ日時とエラーの有無がわかります。3段目は2〜4週間ほどあけてからAIに同じ質問をして、答えに使われるページが変わったかを見ます。
株式会社TROBZのトロパスには、AIサイト監査の機能があります。構造化データ・llms.txtと並んで、AIの巡回ロボットへの設定を100点満点で点検します。変更の当日だけで判断するよりも、こうした点検と記録を数週間並べて見るほうが変化をつかみやすくなります。
確かめる3つの段階
アクセスの記録で名前と番号を見る
サーバーのアクセスの記録には、訪れたプログラムの名前とページ、返した番号が残ります。レンタルサーバーなら、管理画面から記録を取り出せることがよくあります。記録の中で「GPTBot」や「ClaudeBot」などの名前を検索し、返した番号が200かどうかを確かめます。
名前が1件も無ければ、巡回そのものが来ていないか、手前で断られている可能性があります。月に1回、同じ手順で名前ごとの件数を数えておきましょう。
なりすましを見分ける
クローラーの名前は、誰でも名乗ることができます。そのため、記録に名前があっても本物のクローラーとは限りません。OpenAIやGoogleなど一部の運営元は、クローラーが使うIPアドレスの一覧を公開しています。
記録のIPアドレスをこの一覧と照らし合わせると、本物かどうかを見分けられます。怪しいアクセスが多いときは、名前ではなくIPアドレスの一覧で許可する設定を検討してください。
9. サーバー側のアクセス制限との関係
robots.txtで許可していても、サーバー側で断っていれば読めません。このファイルは読む前のお願いで、サーバーの設定は実際の門のような役割です。両方がそろって初めて、クローラーはページの中身を受け取れます。そのため、AIに読まれない理由を探すときは2つを分けて確かめます。
サーバー側の制限には、.htaccessでの遮断・WAFと呼ばれる防御の仕組み・CDNのボット対策などがあります。どれも、名前やIPアドレスや短時間のアクセス数を見てアクセスを断ります。最近は、CDNやサーバーの管理画面にAIのボットを断る切り替えが用意されていることもあります。この切り替えが、知らないうちに有効になっている例も見られます。
現場でよくあるのは、ファイルだけを直して原因が解けたと思い込むケースです。記録に403が並び続けているなら、原因はサーバー側にあります。サーバーやCDNの管理画面を開き、ボットの遮断に関する設定を一覧に書き出してください。
制作会社やサーバー会社と役割を分ける
サーバー側の設定は、制作会社やサーバー会社が管理していることがよくあります。自社だけでは設定画面に入れない場合もあります。その場合は、通したいクローラーの名前の一覧を渡すと話が早く進みます。
頼むときは、管理画面やログインの守りは残したまま公開ページだけ通すよう条件を添えてください。返事をもらったら、記録で番号が200に変わったかを自分でも確かめましょう。
断る理由がある場合の考え方
サーバーの負荷やコンテンツの扱いを理由に、AIのクローラーを断りたい場合もあります。その判断自体は、サイトの持ち主が決めてよいものです。ただし、断るとAIの答えの材料から外れることは理解したうえで決めましょう。
負荷が理由なら、全面的に断る前に巡回の多いページを特定し、その範囲だけを止める方法もあります。決めた内容と理由は、次に見直す日付とあわせて記録に残してください。
10. AIに読まれる入り口を守り続けるために
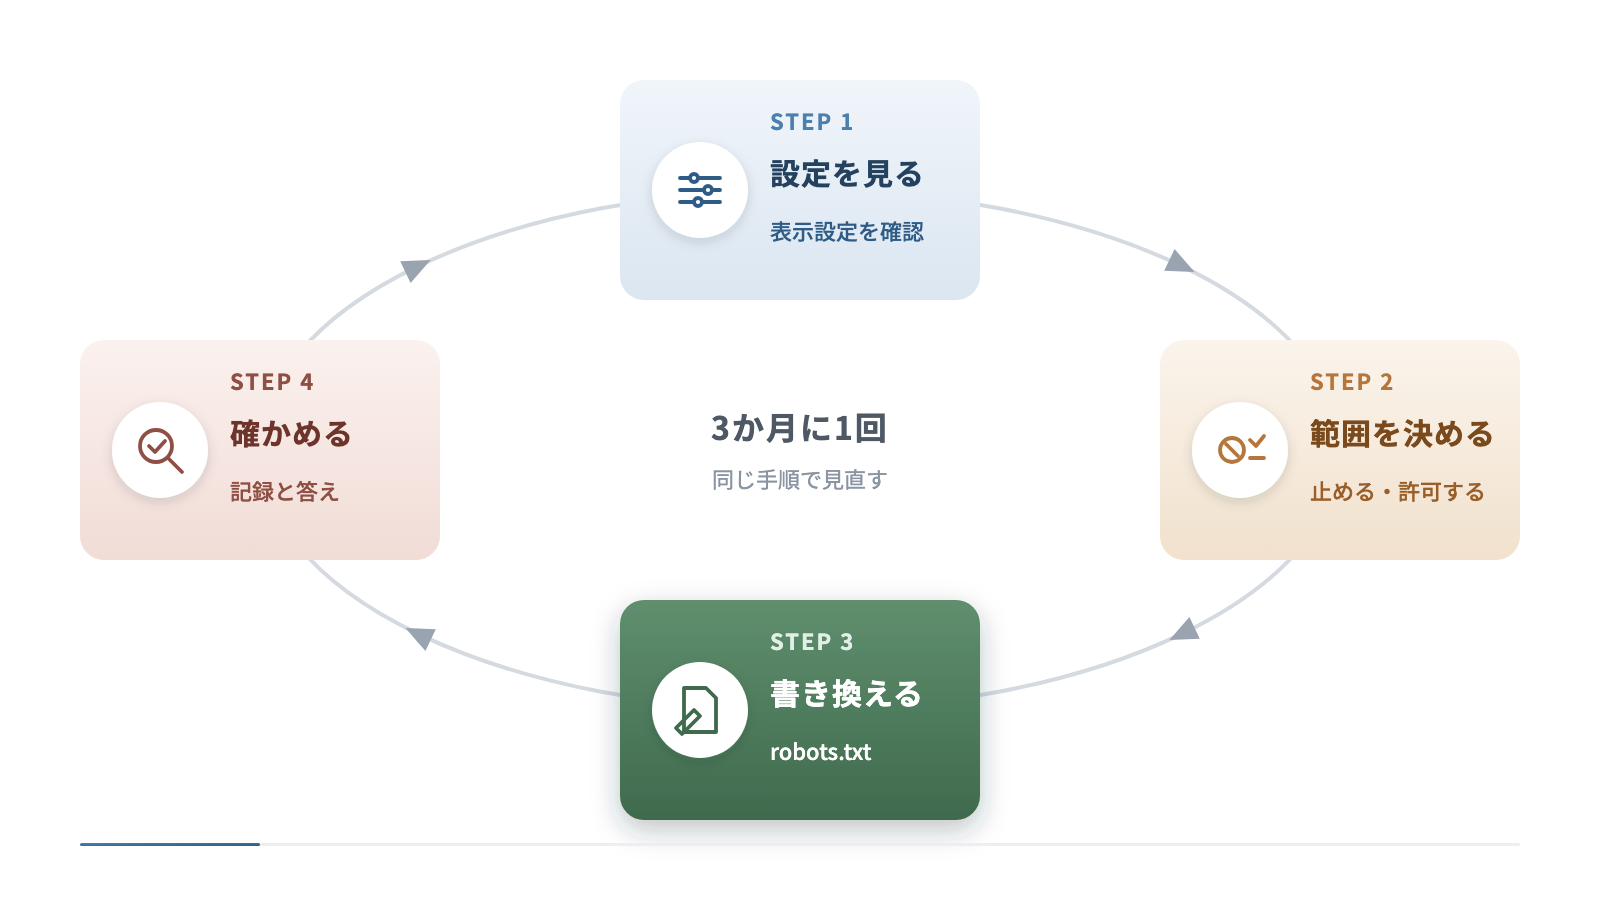
AIに読まれる入り口を守り続けるには、3か月に1回の点検を同じ手順で続けることが近道です。AIのクローラーの名前は追加や変更があり、サイトのプラグインも更新で動きが変わります。一度正しく設定しても、半年後も同じ状態とは限りません。そのため、点検の日を予定に入れて同じ表で結果を残していきます。
点検はファイル・記録・答えの3段で行います。プラグインを入れ替えたときやサーバーを移したときは、その週のうちに臨時の点検を足します。運営元の公式ページも同じ日に開き、名前の追加や変更が無いかを確かめます。点検の結果は、日付・見た項目・直した内容の3列で残すと見返しやすくなります。
よくある失敗は、点検の担当が決まっておらず誰も見ない期間が続くことです。サイトの更新を外部に任せていると、設定の変更に気づくのがさらに遅れます。社内で担当者を1人決め、次の点検日を今日のうちに予定に入れてください。
点検の結果を1枚の表にまとめる
点検の結果は、1枚の表にまとめておくと引き継ぎが楽になります。表には、クローラーの名前・役割・方針・最後に確かめた日を並べます。方針の欄には「許可」「学習用のみ拒否」のように、決めた扱いを短い言葉で書きます。
担当者が替わったときも、この表があれば理由をたどれます。表はサイトの運用の手順書と同じ場所に置いておきましょう。
読まれたあとの答えまで見る
入り口を整えたら、AIの答えの中身まで見ると点検が完成します。読まれるようになっても、答えに使われる文章がサイトに無ければ自社の名前は出にくいままです。答えでの紹介のされ方は、同じ質問を何度か聞いて割合で見るのが基本です。
トロパスでは、6つのAIに業種や地域に合わせた質問を投げ、返ってきた答えの文章をそのまま保存して読み返せます。入り口の点検と答えの記録を並べて、次に直す場所を決めていきましょう。
AIのクローラーを止めずに入り口を整える要点
AIのクローラーが読めるかどうかは、robots.txtとサーバーの設定の両方で決まります。学習用と検索用を分けて方針を決めると、止めすぎも許可しすぎも防げます。WordPressの表示設定やセキュリティのプラグインは、ファイルの外でクローラーを断ることがあります。設定のあとはファイル・記録・答えの3段で確かめ、3か月ごとに見直してください。
AIクローラーとrobots.txtに関するよくある質問
robots.txtでAIのクローラーを止めると検索順位は下がりますか
A. 学習用だけを止めても検索の表示は変わりません。
GPTBotやGoogle-Extendedは検索の順位づけに使われません。ただしGooglebotを止めると、検索とAI Overviewsの両方から外れていきます。
自社サイトがAIのクローラーを止めているかはどう確かめますか
A. サイトのURLの末尾に「/robots.txt」を付けて開きます。
AIの名前の下に「Disallow: /」があれば止めています。サーバー側の遮断もあるため、アクセスの記録もあわせて見ます。
AIの答えに出たいならどのクローラーを許可すればよいですか
A. 各社の検索用のクローラーを許可するのが基本です。
OAI-SearchBotやPerplexityBotなどが答えの材料を集めます。Googleについては、通常の検索と同じGooglebotを許可しておきます。
robots.txtを直したらすぐに反映されますか
A. 反映までに1日ほどかかることがあります。
Googleはこのファイルを最大24時間ほど保存してから読み直します。変更から数週間あけて、AIの答えの変化を確かめてください。
ABOUT THE AUTHORこの記事の執筆者
畔栁 洋志KUROYANAGI YOJI
株式会社TROBZ 代表取締役
保有資格SEO検定1級(全日本SEO協会)
2024年に株式会社TROBZを創業。AI検索・SEO・MEOの対策サービスと、AI分析ツール「トロパス」を自社で開発・提供している。Mission:AI時代の見つかる仕組みを設計する

- 2024年TROBZを創業
- 6種類トロパス計測AI数
- 12件導入事例を掲載
- 95%以上サービス継続率
COMPANY運営会社
- 会社名
- 株式会社TROBZ(トロブズ)
- 設立
- 2024年11月12日
- 所在地
- 愛知県名古屋市中村区名駅3-4-10 アルティメイト名駅1st 2階
- 事業内容
- 生成AI検索最適化・SEO対策・MEO対策・Webサイト制作 ほか
- 法人番号
- 3180001164195
RELATED ARTICLES
 AIの答えに出ているか確認